MLP 实践
单个 Batch 的训练过程
整体而言,如何在一个 batch 上训练模型:
清空梯度 → 前向传播 → 计算损失(交叉熵) → 反向传播 → 更新参数
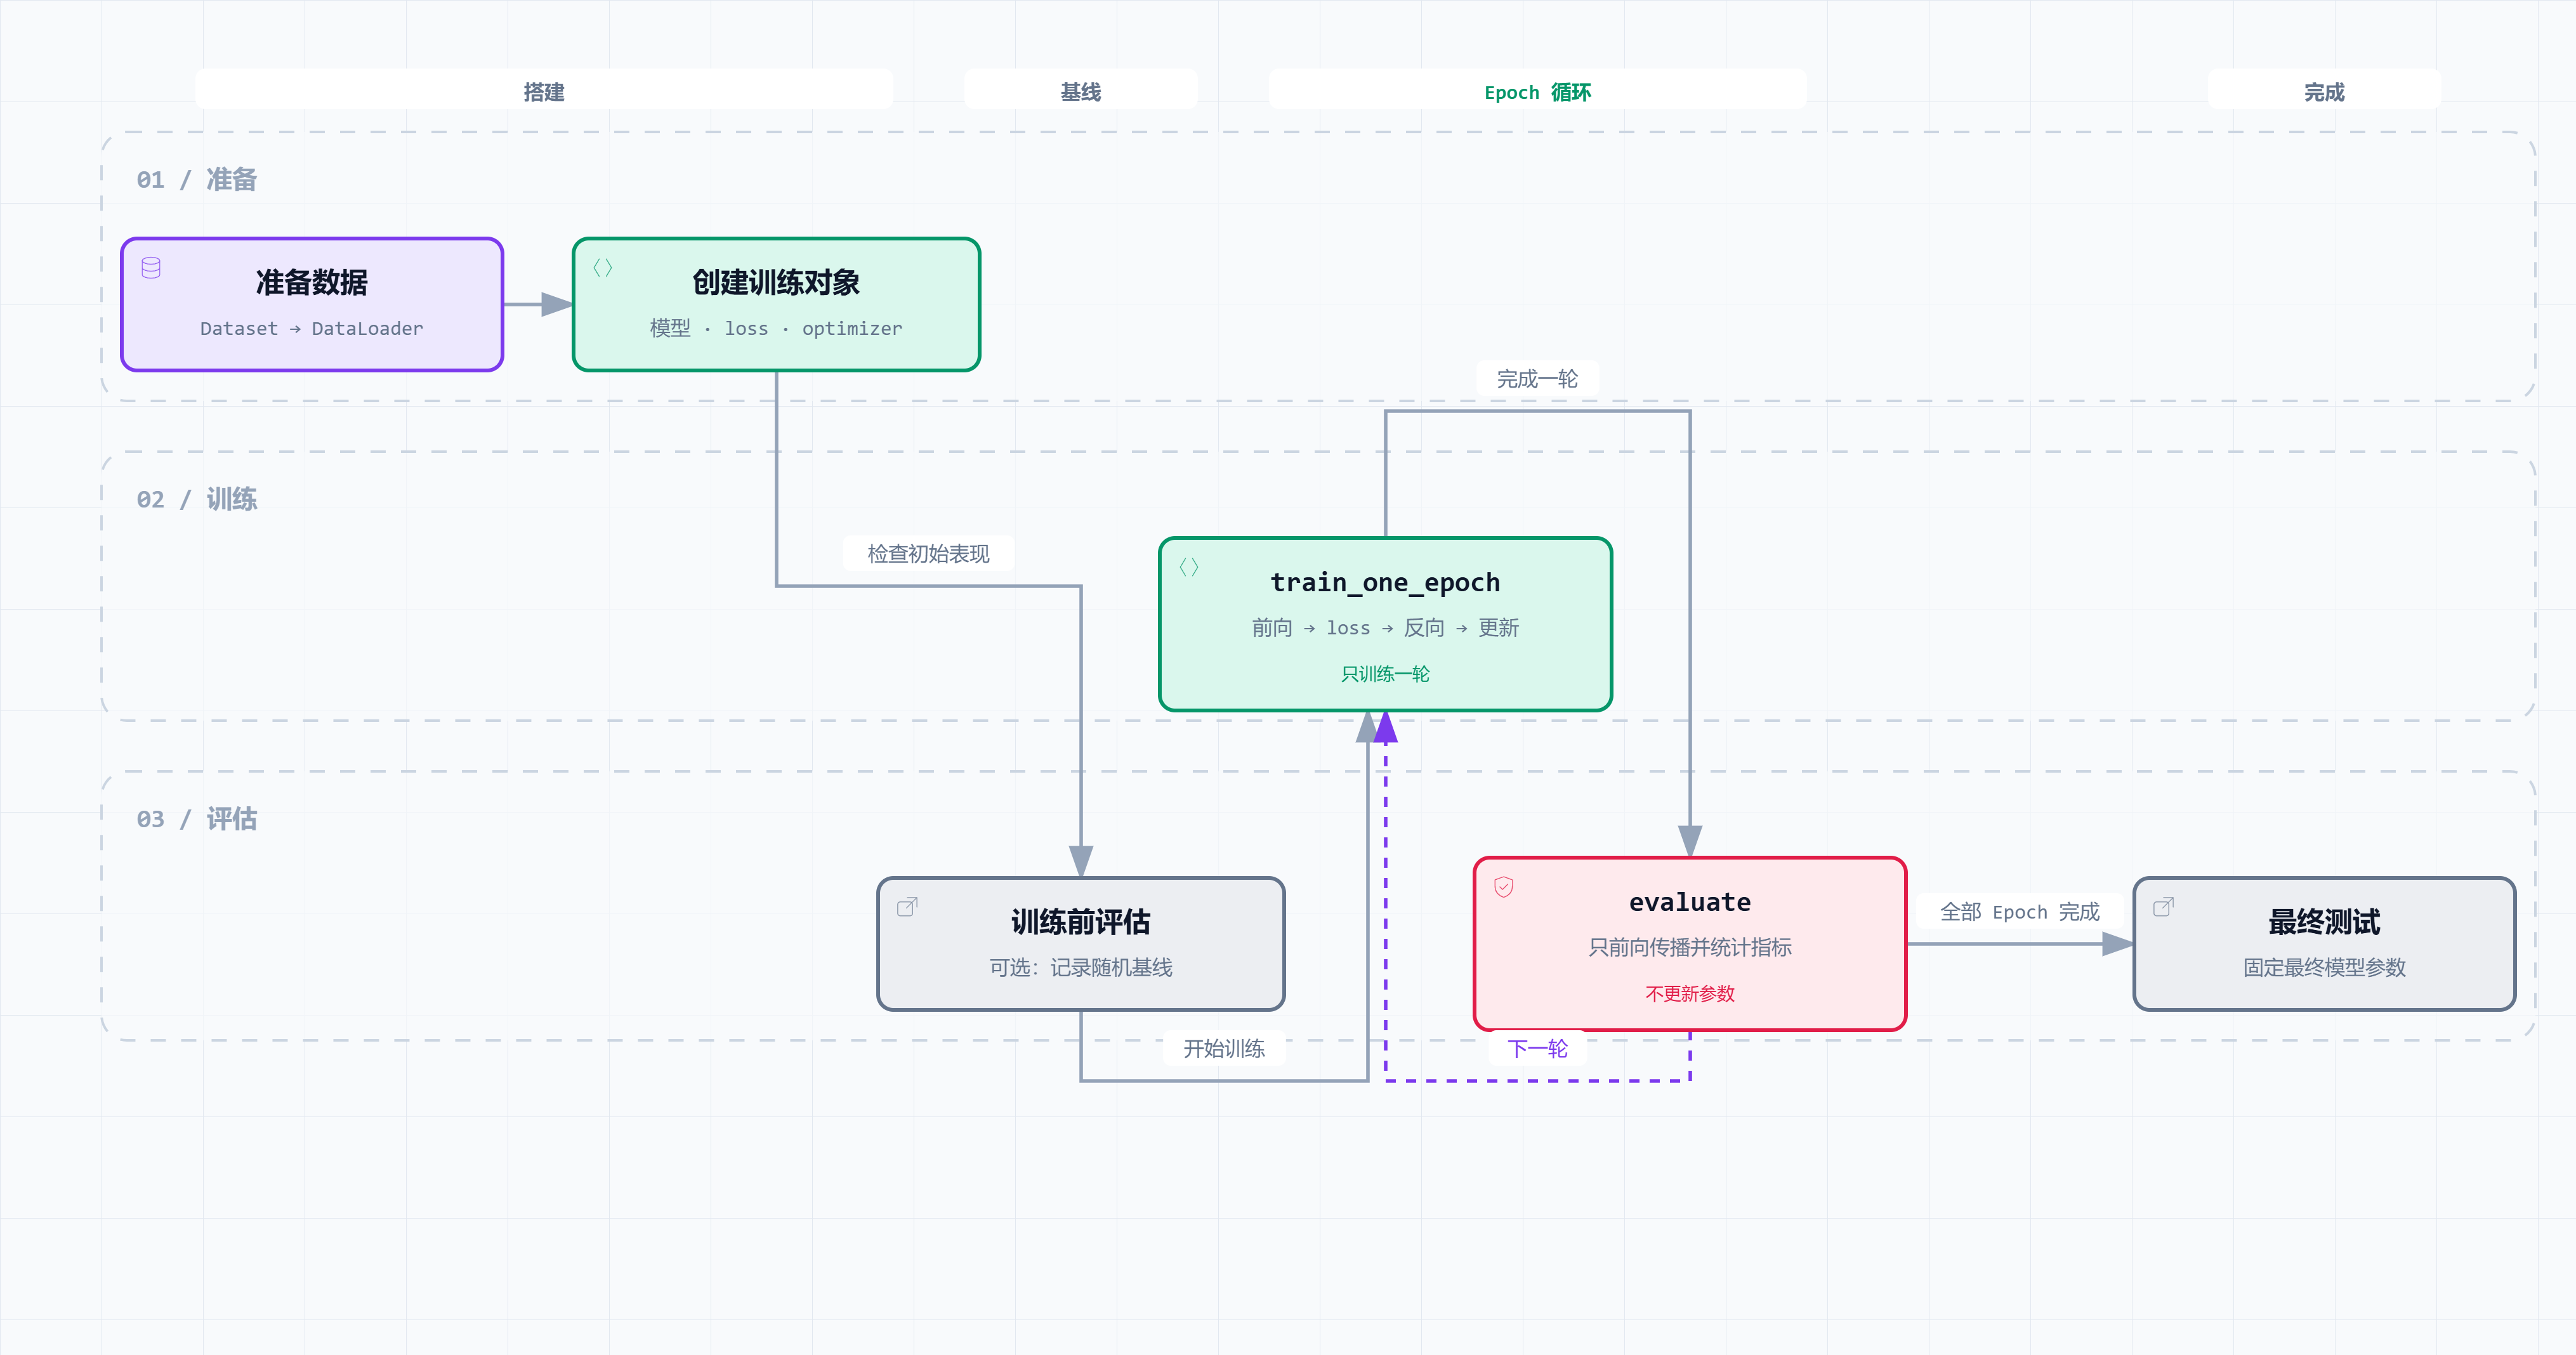
整体代码结构
-
创建
Dataset和DataLoader迷思:如何把训练数据转化为代码能读入的数据大概挺重要的,联想到之后的
word embedding -
定义模型类
__init__:定义网络层forward:定义前向传播
-
定义
train_one_epochmodel.train()- 前向传播 →
loss→ 清空梯度 - → 反向传播 → 更新参数 → 统计指标
-
定义
evaluatemodel.eval() + inference_mode()- 前向传播 → 统计指标
- 不反向传播,不更新参数
-
main- 创建各对象并控制
epoch循环
- 创建各对象并控制
思维导图参考
代码结构实例
...

class MLP(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        ...

    def forward(self, x):
        ...


def train_one_epoch(model, dataloader, loss_fn, optimizer):
    ...


@torch.inference_mode()
def evaluate(model, dataloader, loss_fn):
    ...


mlp_on_mnist = MLP()
optimizer = torch.optim.SGD(mlp_on_mnist.parameters(), lr=0.1)
loss_fn = nn.CrossEntropyLoss()

for epoch in range(EPOCHS):
    ...
训练结果
Before training: loss 2.3117,accuracy 10.63%
After training:  loss 0.0815,accuracy 97.63%